

前回、日本語の文字起こしを Whisper・Gemini・Deepgram の3つで測り、精度では差が無かったと書いた。朗読で 13.0〜13.3%、差は 0.3 ポイントしかない。

その数字が出るまでに、測り方で3回転んでいる。どれも、エンジンを替えたときよりずっと大きく数字が動いた。前回は結論を急いだので短く済ませたが、今回はその3回を順に書く。
ベンチマークの数字を読む側にとっては、エンジンの話よりこちらのほうが役に立つと思う。
先に結論 — 文字起こしの精度を動かしたのは、エンジンより測り方だった
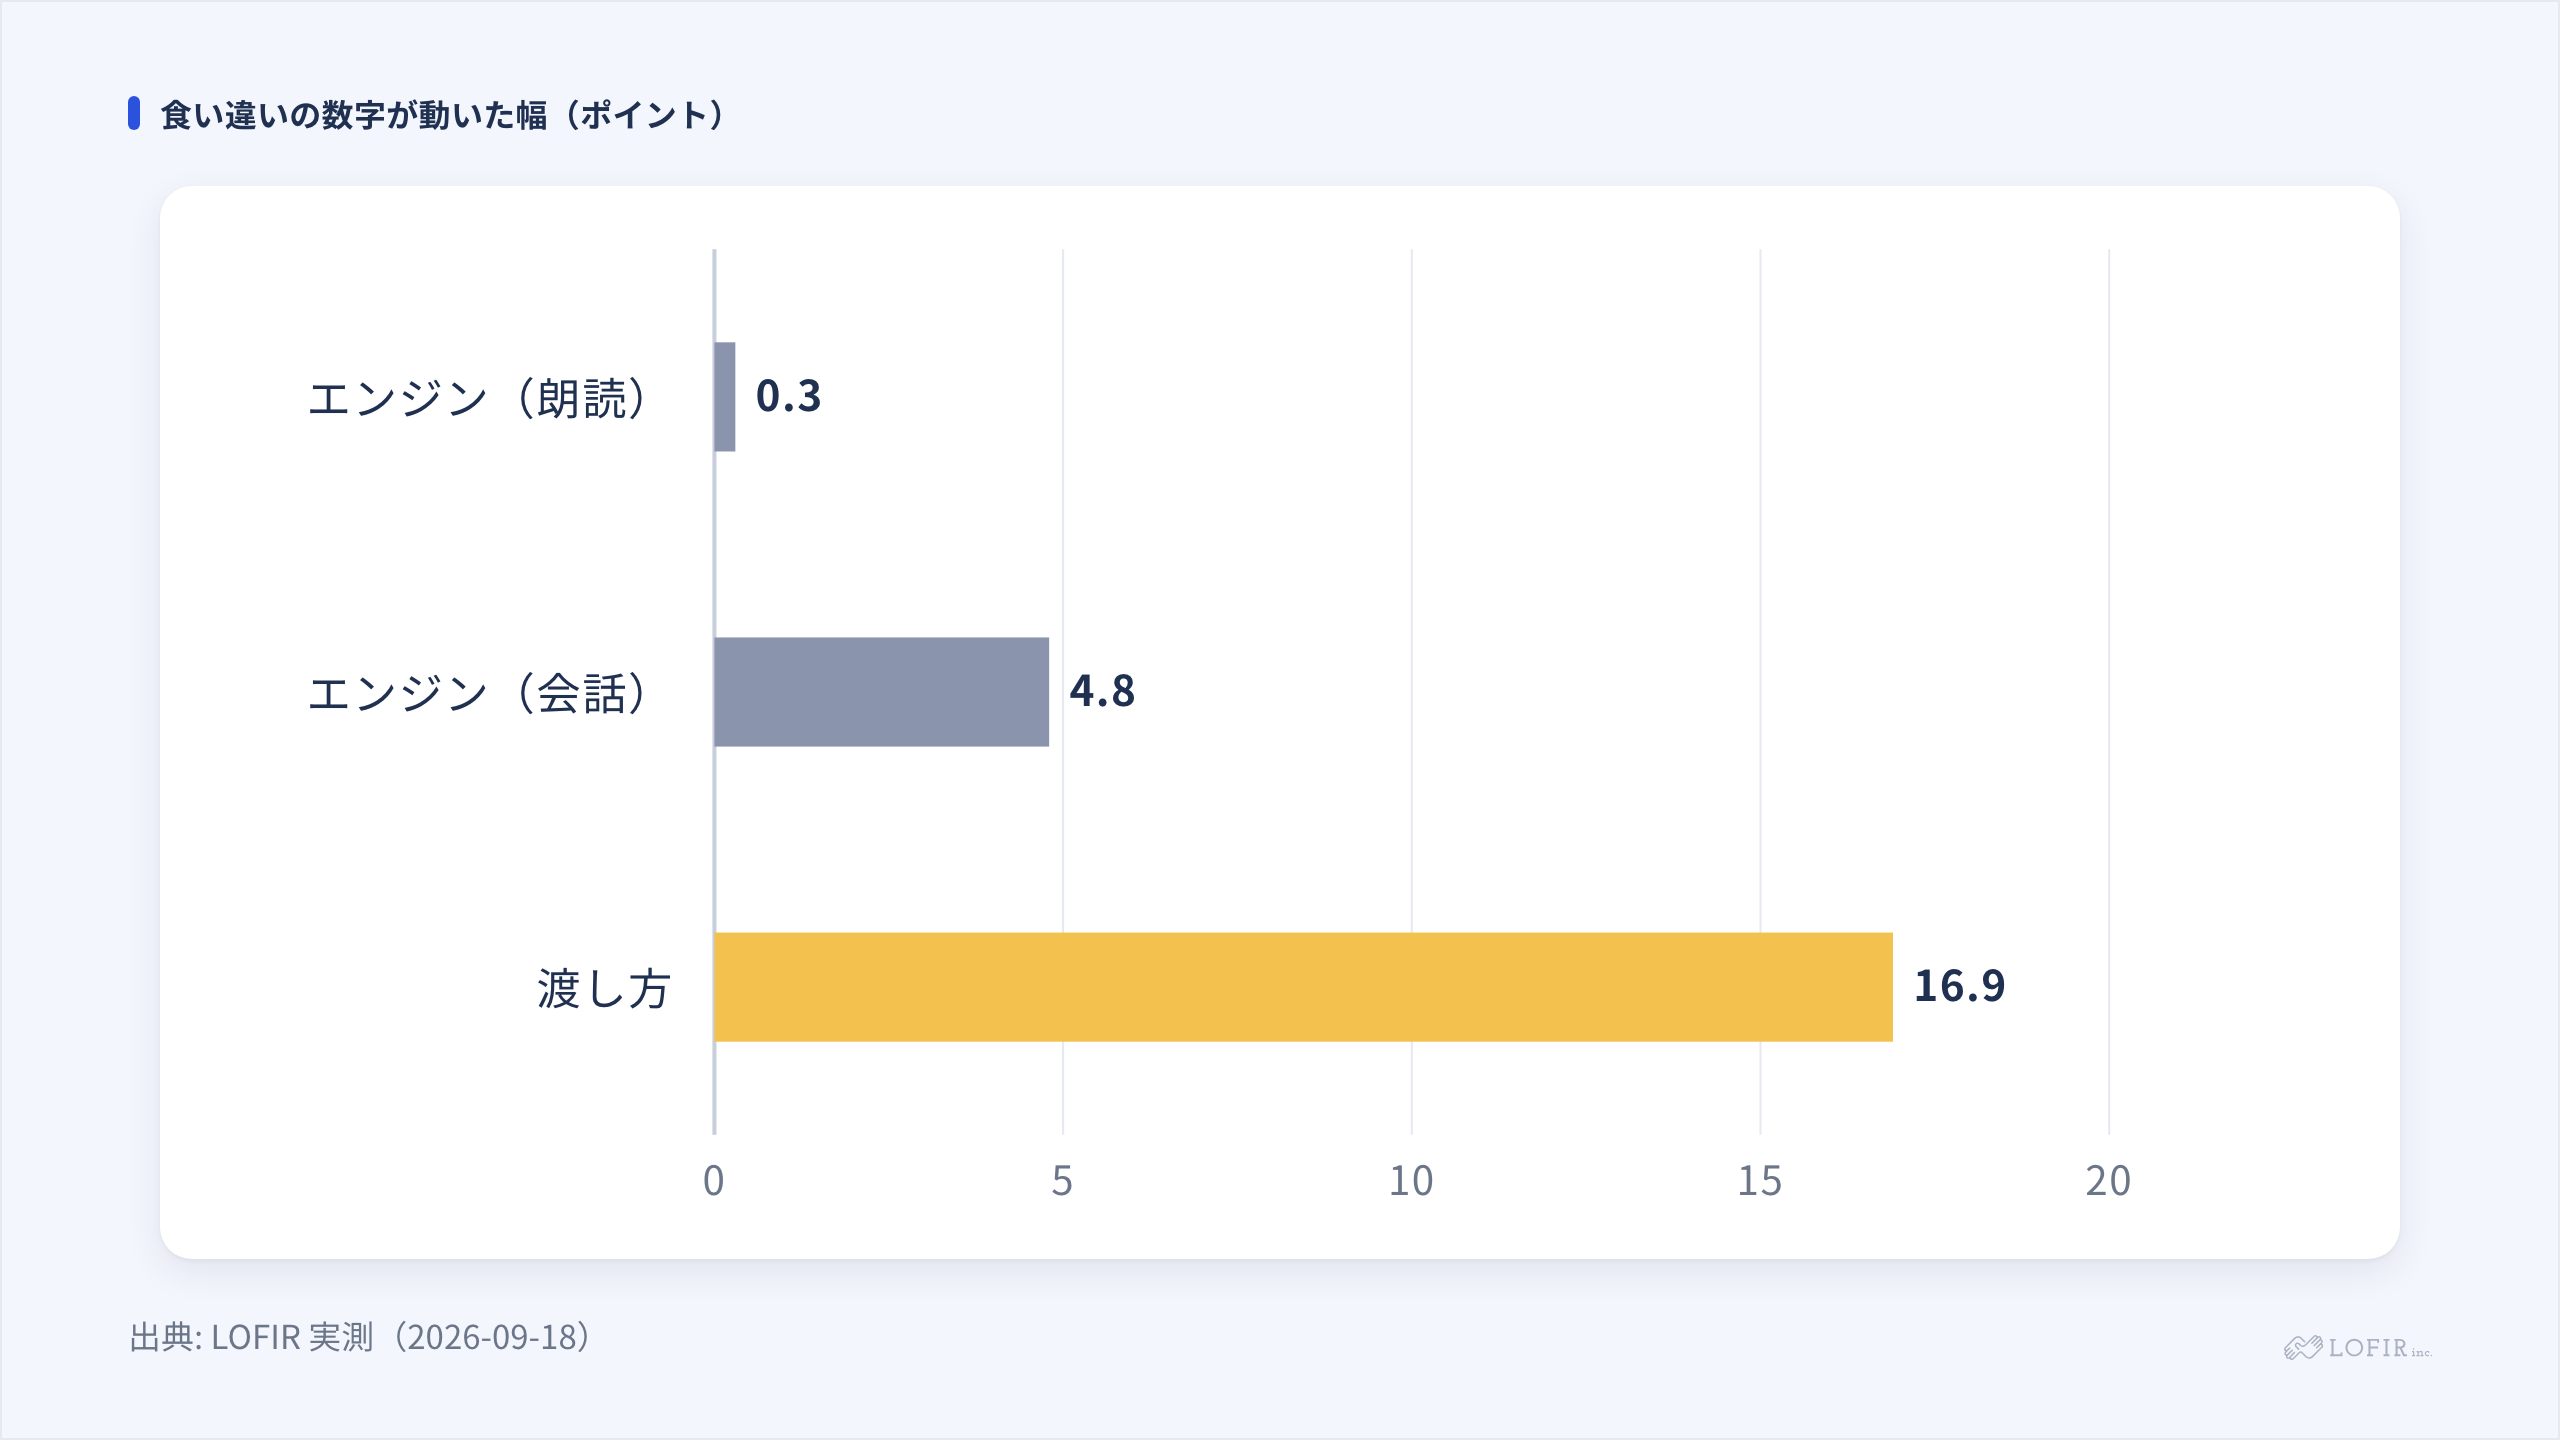
同じ台で測ったなかで、何を変えると数字がどれだけ動いたかを並べる。
| 変えたもの | 数字の動き | 何と何の差か |
|---|---|---|
| エンジン(朗読) | 0.3 ポイント | Whisper 13.0% / Gemini・Deepgram 13.3% |
| エンジン(会話) | 4.8 ポイント | Deepgram 38.2% / Whisper 43.0% |
| 表記のそろえ方(+本物の声に替える) | 順位が入れ替わる | そろえる前は Deepgram 1.2%・Whisper 7.1% |
| Whisper への音声の渡し方 | 16.9 ポイント | まるごと 13.0% / 静かなところで切る 29.9% |
| 会議用の設定のまま測る | 出力が空になる | 10 分の音声が 1 文字も返らない |
数字はどれも正解との食い違いで、小さいほど良い。正解の文字数に対して、何文字直せば一致するかの割合だ。
エンジンを替えて動いたのは、朗読で 0.3 ポイント、会話でも 4.8 ポイントだった。渡し方を替えただけで 16.9 ポイント動いている。エンジンも音声も同じまま、朗読でエンジンを替えたときの 50 倍以上動いたことになる。
転倒① 表記をそろえないと、精度ではなく「書き方の一致」を測ってしまう
最初は、macOS の読み上げ機能(say コマンド)で作った合成音声で測った。原稿があるので、正解がはっきりしているからだ。
出てきた数字は Deepgram 1.2%、Whisper 7.1%、Gemini 10.0%。Deepgram の圧勝に見えた。
ところが 3 つの出力を並べると、文としてはどれも正しかった。差はこういうところにしか無い。
- 「三つ」と「3つ」
- 「二万ミリメートル」と「2万mm」
原稿は漢数字で書いてあった。だから漢数字で書き出すエンジンほど、正解と文字が一致して得をしていた。聞き取りの良し悪しではなく、書き方の好みが原稿と合っているかを測っていたことになる。
直す道具のほうでも転んだ
そこで、採点の前に書き方をそろえる処理を入れた。全角・半角をそろえ、「ミリメートル」を「mm」に、漢数字を算用数字に置き換えてから比べる。
この処理自体で、もう一度つまずいている。記号を落とす処理を先にかけると、長音の「ー」も記号として消えるので、「ミリメートル」が「ミリメトル」になる。そうなると単位の置き換えが一件も当たらない。単位を置き換えてから記号を落とす、という順番にして、ようやくそろった。
そろえ方はいまも完璧ではない。「十」「百」「千」は落としているだけなので、「二百」と「200」は一致しない。こうした粗さが採点に残っていることは、数字と一緒に書いておくべきだと思っている。
そろえたら、合成音声では差が消えた
書き方をそろえると、合成音声でのエンジン間の差はほとんど無くなった。合成音声は発音が明瞭で、言い淀みも雑音も無い。どのエンジンでも文として完全に起こせるので、差の出ようがなかった。
そこで、112 人が読み上げた Common Voice の日本語音声に切り替えた。前回の 13.0〜13.3% はこちらの数字だ。
前回は「表記をそろえたら逆転した」と一言で書いたが、正確には 2 つ直している。書き方をそろえたことと、合成音声をやめて本物の声にしたことだ。圧勝に見えた Deepgram は、この 2 つを直すと Gemini と並んで 13.3% になり、Whisper の 13.0% にわずかに及ばなかった。
転倒② Whisper に音声をどう渡すかで、同じエンジン・同じ音声の精度が 2.3 倍変わる
会議中の文字起こしは、音声を区切りながら順に送っている。だからベンチでも、はじめは同じように区切ってから Whisper に渡していた。
区切り方だけを変えて、同じ Whisper・同じ音声(Common Voice 9.8 分)で測り直した。
| 渡し方 | 切れ目を決めているのは | 食い違い |
|---|---|---|
| まるごと 1 回 | Whisper 自身(言い終わった文の終わり) | 13.0% |
| 25 秒ごとに機械的に切る | こちら(時間で一律) | 22.6% |
| 静かなところで切る | こちら(無音を探す) | 29.9% |
Whisper は、窓の切れ目を自分で選んでいる
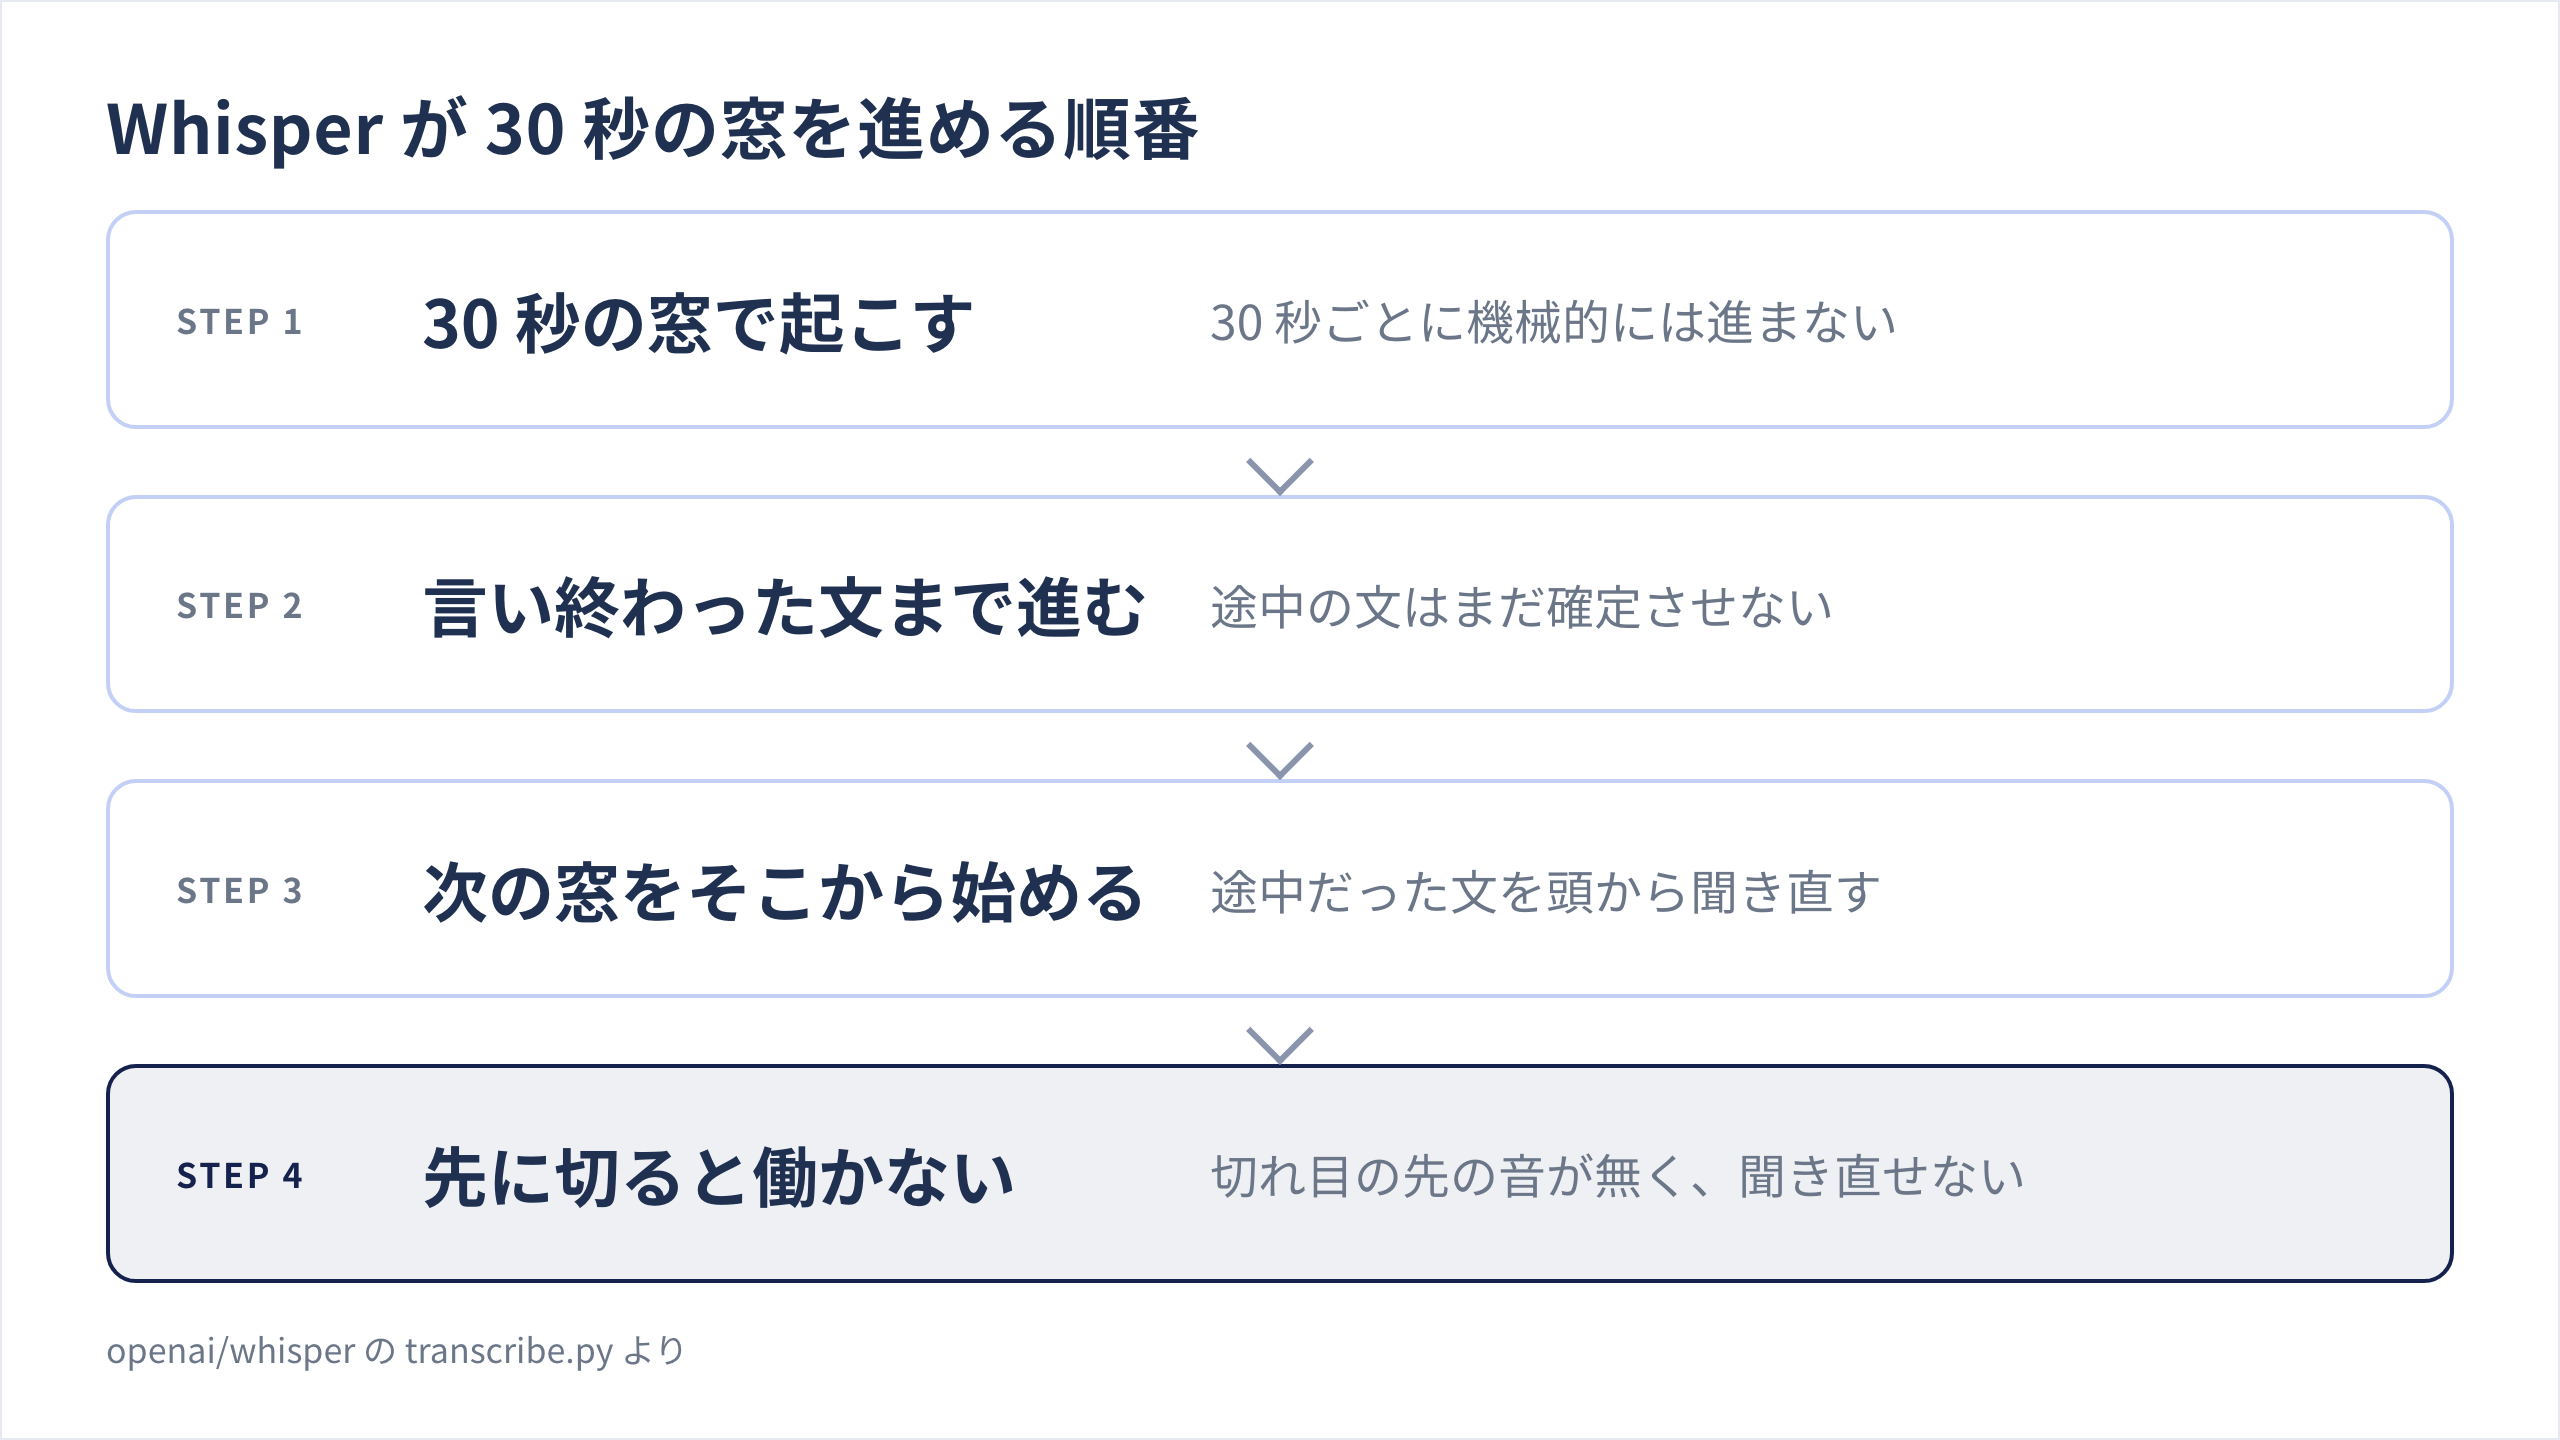
Whisper は 30 秒ずつ音声を見る。ただし 30 秒ごとに機械的に進むわけではない。公式の実装を読むと、30 秒の窓で文字を起こしたあと、最後に言い終わった文の終わりまでしか進まず、次の窓をそこから始める。文の途中で窓が終わった場合、その文は次の窓でもう一度頭から聞き直される。
こちらで先に 25 秒で切ると、この仕組みが働かない。切れ目が文の途中に来ても、Whisper にはその先の音が無いので、聞き直しようがない。
静かなところで切ると、さらに悪くなった
意外だったのは、無音を探して切ったほうが、時間で一律に切るより悪かったことだ(22.6% 対 29.9%)。静かなところなら文の途中で切らずに済むので、良くなると思っていた。
理由はまだ切り分けていない。手がかりとして、Whisper は 30 秒に満たない音声を無音で埋めてから処理する。静かなところで切ると短い断片が増えるので、中身の大半が無音という窓が増える。これが悪化の原因になっている可能性はあるが、確かめてはいない。
転倒③ 本番用の安全装置が、ベンチマークでは出力を丸ごと消した
10 分の音声を手元の Whisper に渡したら、文字起こしが 1 文字も返ってこなかった。エラーは出ていない。空の結果が、正常に返ってきた。
原因は、会議用に入れていた安全装置だった。Whisper は起こした区間ごとに「どれくらい自信があるか」の値を出す。会議中は、いちばん自信の低い区間がしきい値を下回ったら、その回の出力をまるごと捨てるようにしている。無音や雑音から存在しない文を作ってしまうのを防ぐためだ。
会議中は短い窓ごとに判定するので、区間は数個しかない。10 分の音声をまるごと渡すと区間は数十から百を超え、その中のどれか 1 つが下回れば全部捨てる。音声が長いほど、どこかで引っかかるのは避けられない。
空の出力を採点すると、食い違いは 100% になる。今回は全部消えたので気づけたが、半分だけ削れていたら「このエンジンは精度が悪い」と読んでいたと思う。比較するときはこの設定を外した。逆に、会議中の精度を名乗るなら、安全装置を入れたまま測る必要がある。この 2 つは別の問いだ。
ベンチマークの 13.0% は、会議中の文字起こしの精度ではなかった
3 回の転倒を並べて、ようやく気づいたことがある。
手元の Whisper を会議で使うとき、音声はまるごとではなく、いまは無音を探して、長くても 10 秒ほどに区切って渡している。ベンチの条件でいえば、いちばん悪かった「静かなところで切る」(29.9%)に近い。
つまり、前回の表で手元の Whisper に付いていた 13.0% は、条件をいちばん有利にしたときの数字で、会議中の手元 Whisper の精度を表していない。エンジン同士を比べるには公平な数字だが、「会議で使うと何%か」を知りたい人に渡す数字ではない。
これはベンチマークの数字一般に言える。精度の数字は、エンジンの力と、測り方の条件の両方でできている。そして今回、条件のほうが大きく数字を動かした。
ベンチマークの数字を見たら、まず確かめる 5 つ
ベンダーの資料でも比較記事でも、精度の数字を見たら、エンジンの名前より先に次のことを確かめるようにしている。
| 確かめること | 確かめないと起きること | 今回の例 |
|---|---|---|
| 正解は誰が書いたか | 自動の文字起こしを正解にすると、同じ系統のエンジンが勝つ | 会話データは人が書いた字幕のもの(YODAS の ja000)を選んだ |
| 表記をそろえてから採点したか | 精度ではなく書き方の一致を測る | そろえる前は Deepgram 1.2% / Whisper 7.1% |
| 音声をどう区切って渡したか | 同じエンジンで数字が 2 倍以上動く | 13.0% → 22.6% → 29.9% |
| 本番の設定のままか、外したか | 安全装置が出力を消す/外すと本番より良く見える | 10 分の音声が空になった |
| 声は本物か、何人分か | 合成音声や 1 人の声では差が出ない・偏る | 朗読 112 人、会話 59 本の動画 |
このうち 1 つでも書かれていない数字は、そのまま自分の環境の精度として受け取らないほうがいい。
LLM の評価でも同じ転び方をする
この話は文字起こしに限らない。AI の出力を点数にするとき、同じ形の落とし穴がある。LOFIR でも、実際に踏んでいる。
自社の記事採点でも、基準を変えるたびに点が揺れた
LOFIR では、記事の下書きを AI に採点させている。見ているのは、読みやすさ、一次情報の量、情報の正確さ、検索や AI 検索に拾われやすいか、といった複数の観点だ。この採点の基準を足したり直したりするたびに、同じ記事の点が揺れてきた。
| いつ | 変えたこと | 点の動き |
|---|---|---|
| 2026-08-06 | 採点者に渡す本文を、古い版から最終版に替えた | 69 → 77(不合格から合格に) |
| 2026-08-15 | 構成の観点に「節をまたいだ重複」の確認を足した | 構成の点 9 → 6 |
| 2026-08-16 | 正確さの合格線を 6 点・7 点・8 点にしたら、既存 46 本のうち何本落ちるかを数えた | 不合格は 9%・33%・70% |
| 2026-08-26 | 書いた側の自己採点をやめ、誰が書いたかを伏せた別の採点者に替えた | 支援先の記事 5 本がすべて不合格。検索向けの点は 8 → 3〜6 |
1 行目では、記事は何も変わっていない。採点者に見せていた本文が古かっただけで、8 点動いて合否が入れ替わった。文字起こしで「どう渡すか」だけで数字が動いたのと同じ形だ。
2 行目は点が下がったが、記事が悪くなったわけではない。前の基準では、同じ事例を 2 つの節で説明し直している重複が見えていなかった。物差しを足して、初めて見えた欠陥だった。
3 行目は、合格線の引き方ひとつで、同じ記事の山から 1 割も 7 割も落とせるということだ。4 行目では、書いた側が自分で付けた点が甘かったと分かった。見出しを直したのに、本文の中には古い題が残っていた記事が 5 本中 4 本あった。
逆向きの失敗もある。出典の URL が実在したというだけで、存在しない調査の数字が正確さ 7 点で通ったことがある。どれも 1 回ずつの観察で、条件をそろえた実験ではない。それでも、基準や渡し方を変えたときの揺れは、記事どうしの差より大きく出ることが多かった。
論文でも、同じ形の偏りが報告されている
正解や採点者が、測られる側と同じ系統になる。 文字起こしで自動字幕を正解にすると同じ系統が勝つのと同じく、LLM に LLM の答えを採点させると、採点役が自分の書いた答えを高く評価する傾向が報告されている。並べた順番で判定が変わる傾向も同じ論文に出てくる(Zheng et al. 2023「Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena」)。
書き方の違いで正誤が変わる。 「3」と「三」を別の答えとして数えるのと同じことが、答えの書式でも起きる。選択肢の記号で答えたか、文で答えたかの違いだけで、機械の判定が一致しなくなることがある。
本番と測定で条件が違う。 長い文書を区切って渡すか、まるごと渡すか。指示文や設定を本番のままにするか。どれも、モデルを替えたときより大きく結果を動かしうる。
いまの LOFIR の採点は、書いたときとは別の文脈で、誰が書いたかを伏せて行っている。上の表の 4 行目で自己採点の甘さが出てから、この形に替えた。文字起こしで自動字幕を正解にしなかったのと、同じ理由からだ。
測定条件(再現用)
- 2026-09-18 実測。MacBook Pro(Apple M4 Max・128GB)
- 手元の Whisper: mlx-whisper large-v3-turbo
- 朗読: Common Voice 27.0 日本語(CC0)120 クリップ・112 人・9.8 分
- 会話: YODAS ja000(CC-BY-3.0)120 発話・59 本の動画・13.1 分
- 採点は、全角・半角と単位・漢数字をそろえてから文字単位の編集距離で比べた。乱数の種は固定
この仕組みの公開と、導入のご相談について
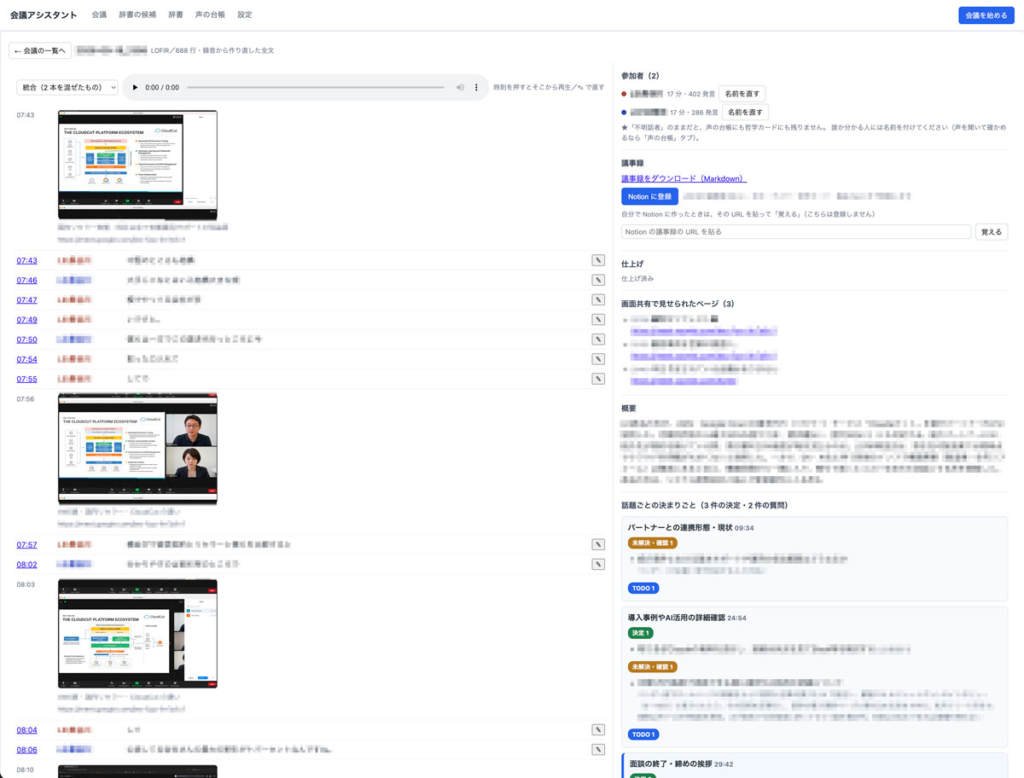
この記事で使っている測定の台は、会議の音声を拾って文字起こしし、会議中に論点と TODO を出し、終わったら議事録まで作る仕組みの一部です。エンジンは処理ごとに選べて、外に出したくない会議はワンクリックで全部手元に戻せます。
この仕組みは 2026 年 9 月 21 日に GitHub で公開しました(Meeting Copilot・MIT ライセンス・macOS 専用)。この記事と同じ測り方を、ご自分の環境で試していただけます。
自社の会議のために作って使っているものを、そのまま公開したものです。完成した製品ではなく、どなたの環境でもそのまま動く形に整えたものでもありません。自由に改造して使っていただく前提です。既定では文字起こしも要約も手元(mlx-whisper と Ollama)で動き、何も外へ出ません。
ただし、設定や導入のご相談は有償にて承ります(無償のサポート窓口は設けていません)。どのエンジンを選ぶか、どう区切って渡すか、何を正解にして測るかは、使う環境でかなり変わります。
ご興味のある方、お困りの方はお問い合わせください。
この記事はどうでしたか?
ひとことメッセージを送る(匿名)
ありがとうございます。受け取りました。- 日本語の文字起こし、3つ測ったら全部同じだった — Whisper / Gemini / Deepgram を会議の道具として選ぶための実測
- 無料 API キーの本当の問題は、無料であることではなかった — Deepgram と Gemini で「学習に使わせない」を確かめた話
CONSULTATION
AI 導入や、Claude Code の導入レクチャー・勉強会・家庭教師も受け付けています。
行き詰まった、分からないところがある——そんなときは、個別の 1on1 や勉強会でご案内できますので、ご希望の場合はお気兼ねなくお問い合わせください。
この記事を書いた人
関連記事
-
 無料 API キーの本当の問題は、無料であることではなかった — Deepgram と Gemini で「学習に使わせない」を確かめた話
-
 日本語の文字起こし、3つ測ったら全部同じだった — Whisper / Gemini / Deepgram を会議の道具として選ぶための実測
-
 MacBookを置いて出かけた休日、スマホ1台でAIに仕事を任せられた——Orcaのスリープ防止とRelay接続
-
 AIに聞かれたとき、自社は挙がるか — 22問×4AIで測ってみた
-
 レンタルサーバーの「AI対応」は3種類ある — ロリポップ・エックスサーバー・ConoHa WING を同じ物差しで比べた
-
 Gmailに移らなくていい——Claude Code × IMAPで受信箱の整理と返信下書きを自動化する
-
 AIに書かせた記事が刺さらない理由は「アーク」が無いからだ
-
 Claude Opus 5の最適なプロンプト設計。自律的な振る舞いを前提に、任せる「範囲と境界」を定義するのがコツ
